7 年のベスト Web スクレイピング ツール 2026: [1 番目が最も信頼できるツール]
Web スクレイピング ツールは、特定の Web サイトから情報とデータを抽出するように設計されています。 これは、データを抽出する Web ページからデータを取得、解析、整理するプロセスです。
これには、Web サイトの HTML コードと対話し、特定のデータを取得し、さまざまな目的でそのデータを保存または処理するためのスクリプトまたはプログラムを作成することが含まれます。
Web スクレイピング ツールは、データ マイニング、分析、価格比較、調査、コンテンツの集約、Web サイトの変更の監視など、さまざまな目的に使用できる時間のかかるデータを収集するためによく使用されます。
以下は、7 年のベスト Web スクレイピング ツール 2026 つです。
1. 明るいデータ
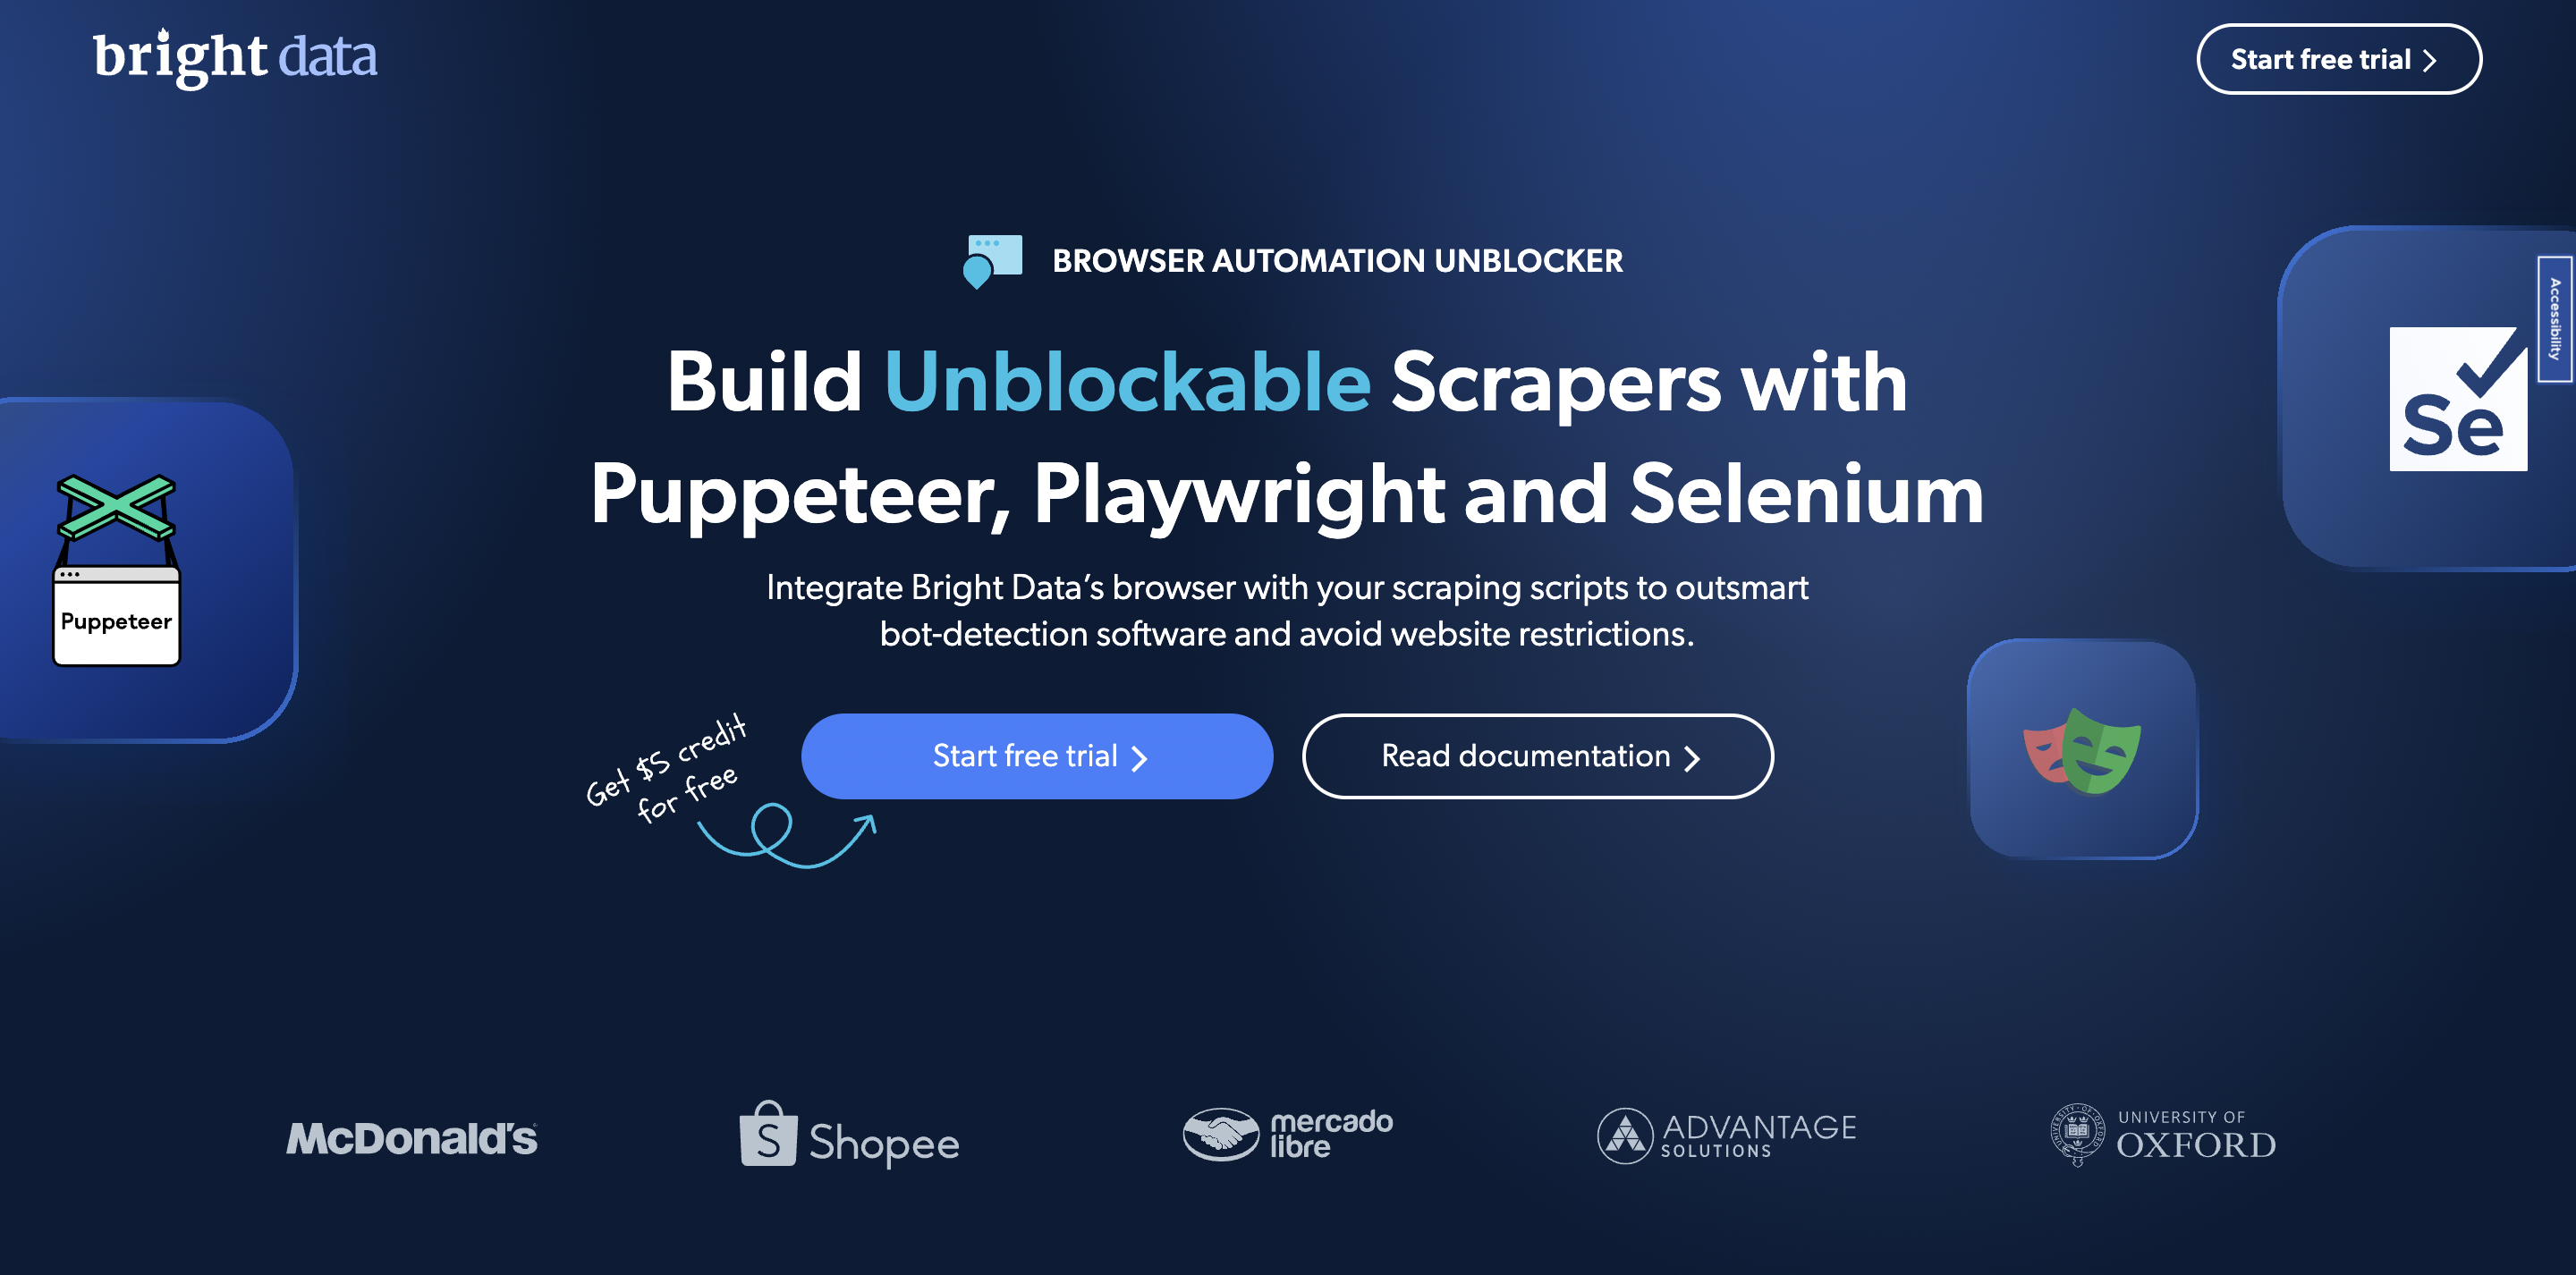
Bright Data は Web スクレイピング ソフトウェアであり、ボットを通じてデータを抽出する役割を果たし、必要なセキュリティとプライバシーも提供します。 これは、ユーザーにとって最初の選択肢となる最高のソフトウェアのXNUMXつです。
データ抽出:このスクレイピングソフトウェアは、複雑な手順なしにスムーズなデータ抽出を保証し、さまざまなソースからデータを収集します。
複数の形式:抽出されたデータと情報は、分類してユーザーにとって便利なように、さまざまな形式で整理されます。形式は、スプレッドシートからCSVまで多岐にわたります。
ウェブ分析:このソフトウェアは、ウェブサイトを分析してユーザーエクスペリエンスを最適化するためのツールセットを提供し、ユーザーにとって有用なウェブサイトをフィルタリングします。
統合機能:Bright Dataは、SwitchyOmega Proxy、MoreLogin、AdsPower Proxy、Undetectableなど、さまざまなプロキシをソフトウェアに統合することで、ウェブサイトのスクレイピング機能を強化します。この統合機能により、ユーザーはより多くのリンク、スクリプト、画像に効率的にアクセスし、有用なデータを収集できます。
スクレイピングブラウザAPI:これはウェブサイトのロック解除に役立ちます。ブロックを自動的に回避し、CAPTCHAやセキュリティチェックを解決します。ウェブスクレイピングを容易にするだけでなく、ユーザーのコストと時間の節約にも役立ちます。Bright Dataのこの機能は、必要なウェブサイトのブロック解除をすべて自動的に管理するため、ユーザーは余計な作業をする必要がありません。
#5 を実現する主な機能 ブライトデータNo.1
1. Bright Data Scraping Browser は使いやすく、初心者にも最適です。
2. Bright Data Web Unlocker には、完全に自動化されたブロック解除機能が組み込まれています。
3. 彼らの成功率は 100% です、それは驚くべきことです。
4. 結果は CSV、HTML、JSON で提供されます
5. 72 万以上のリアルピア住宅 IP を提供します。
ブライトデータの長所と短所
メリット
- Bright Data の公式 Web サイトまたはアプリケーションには、初心者が各ステップで役立つユーザー ガイドが用意されています。
- Playwright (Python)、(Node.js)、Selenium と互換性があります
- 7 日間の無料トライアルが利用可能 + 50 % 割引
- あらゆる言語、国、デバイスから Web データを簡単にスクラップできます。
- Web サイトのブロックを解除し、さまざまなブロック解除ソフトウェアをバイパスするためのさまざまなツールが備わっています。
デメリット
- 一部のユーザーにとっては比較的高価になる可能性があります。
- 8 言語でのみ利用できるため、特定の言語に限定されます。
ブライトデータの価格設定
4 つの異なる料金プランがあるため、ビジネス モデルや要件に応じて最適なものを選択できます。
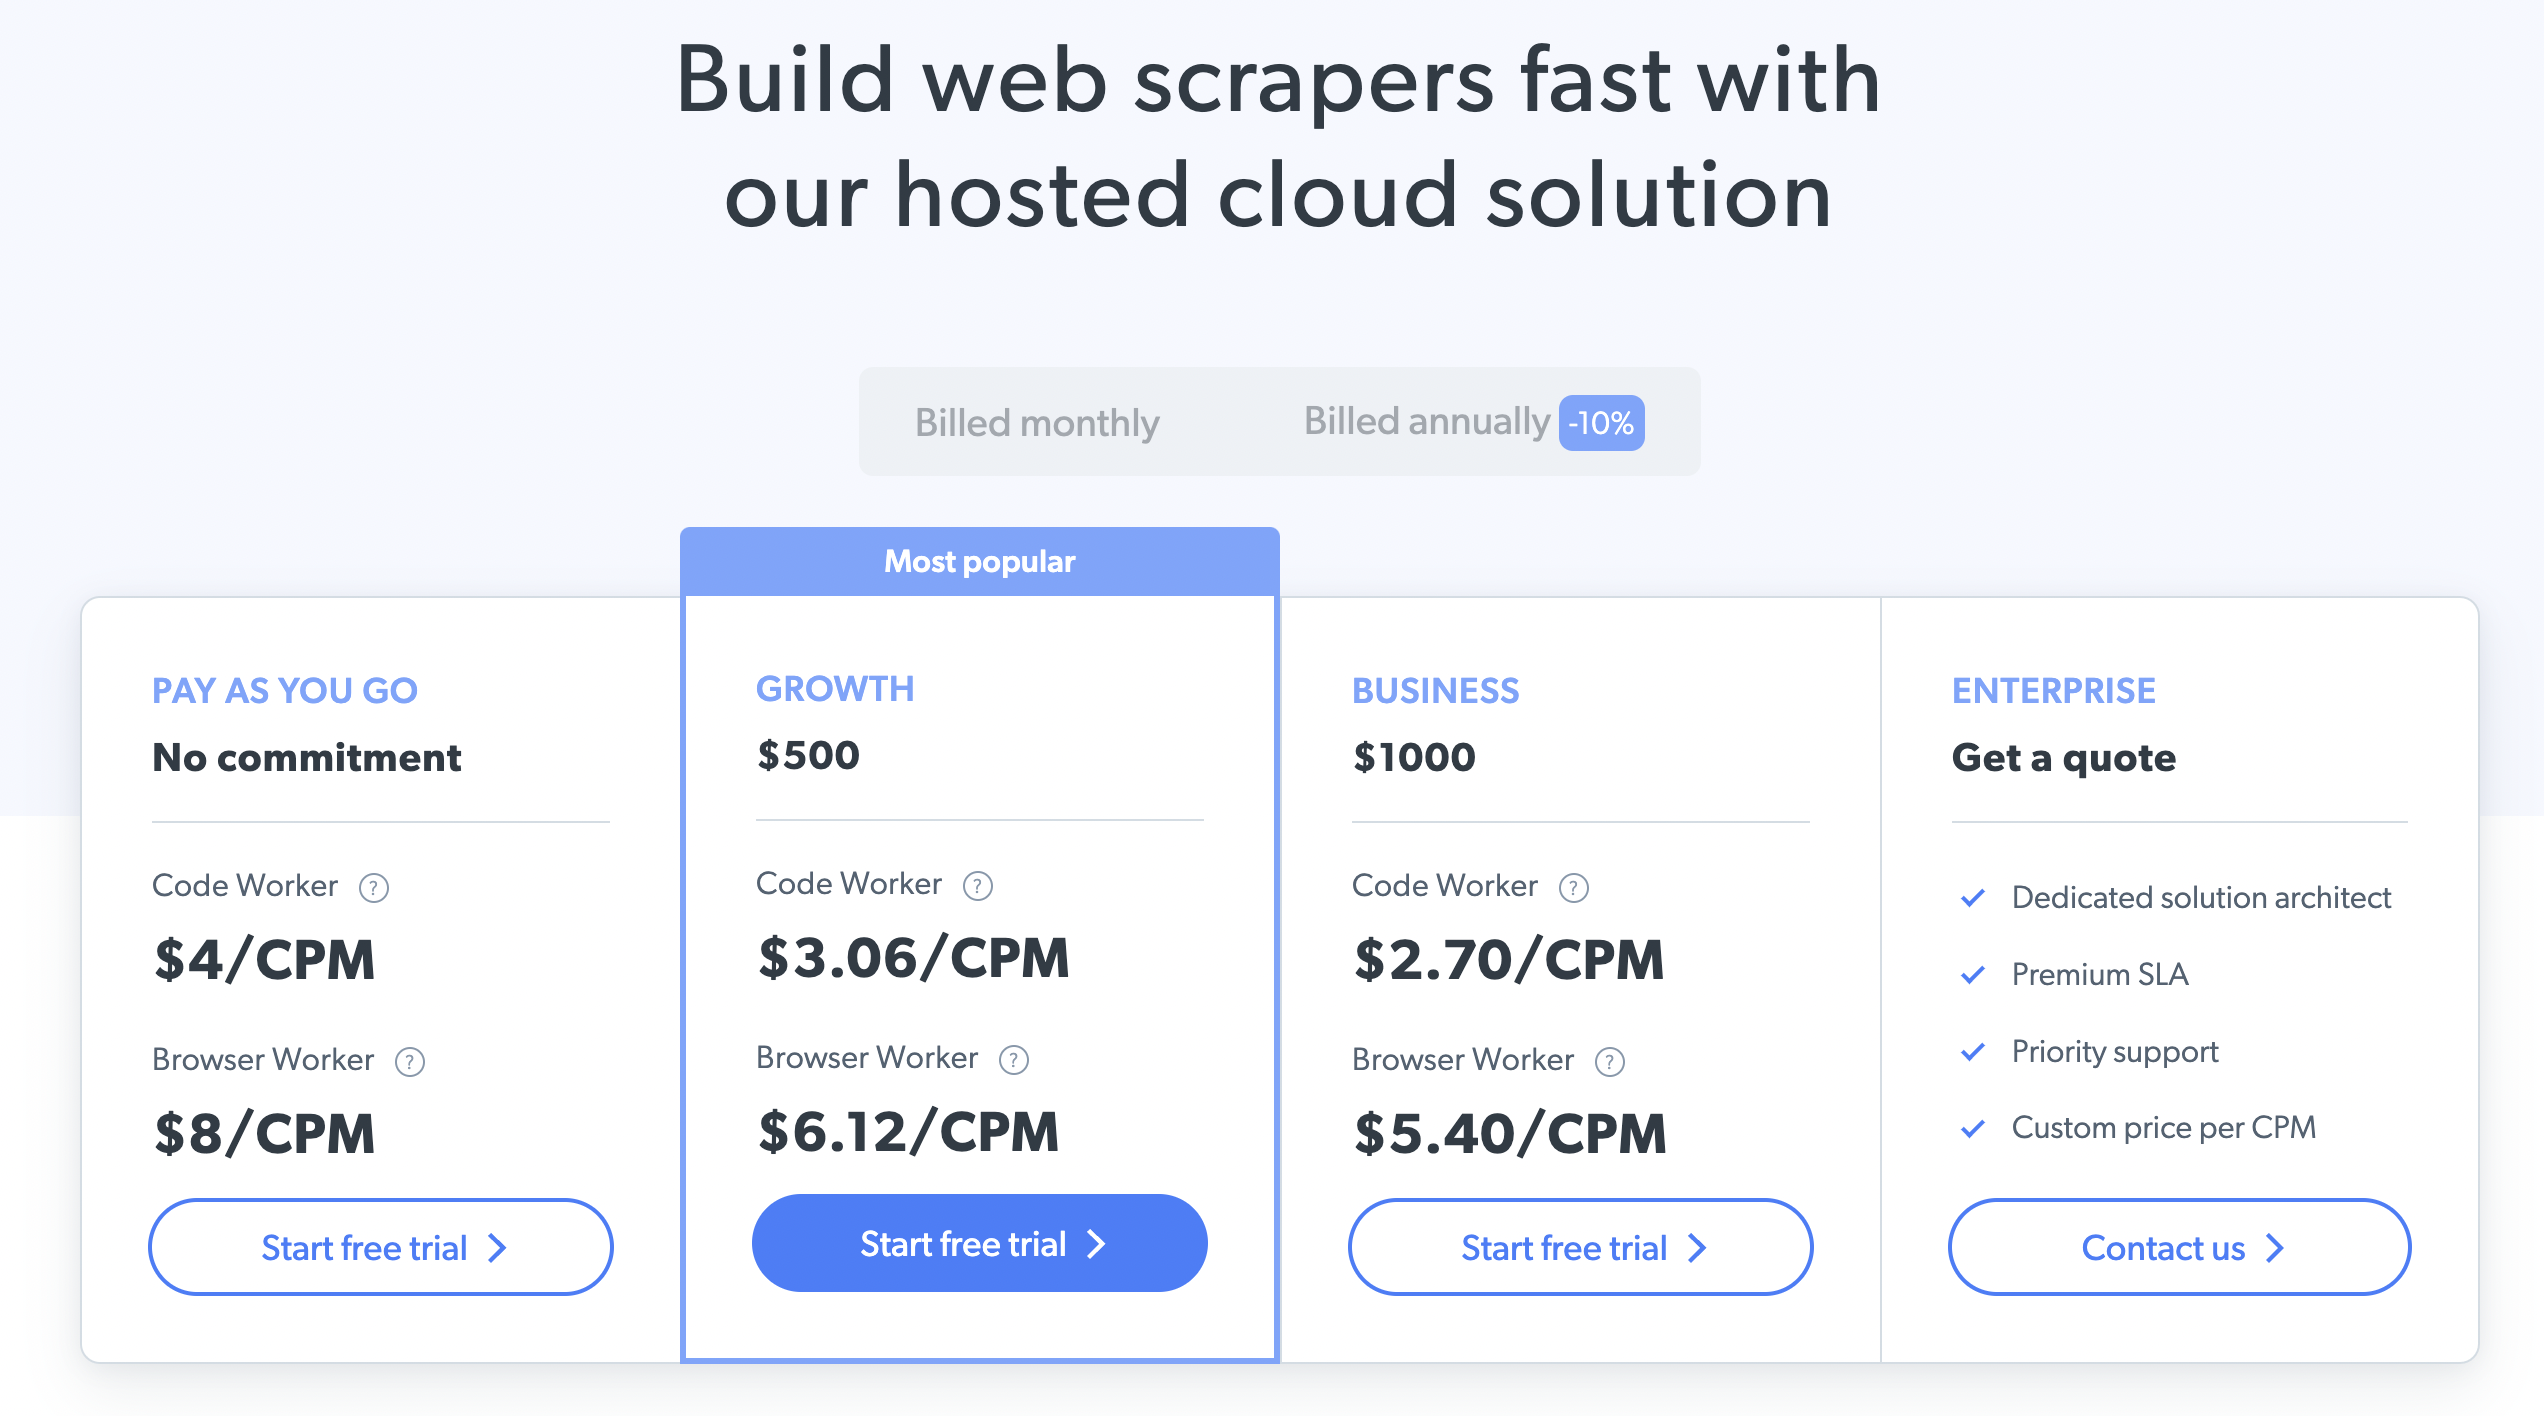
- 使った分だけ: 価格は 4 ドル/CPM から始まります
- 成長計画: 料金は 500 ドル (3.06 ドル/CPM) です。
- 事業計画: このプランは大企業オーナー向けで、料金は 1000 ドル (CPM あたり 2.70 ドル) です。
- エンタープライズプラン: これについては、Bright Data チームに連絡して「見積もりを取得」する必要があります。
Diffbot
Diffbot は、人工知能を使用して Web サイトからデータを抽出または収集するために使用される Web スクレイピング ツールです。
リード検証:ウェブスクレイピングツールであるDiffbotは、リード検証、つまり質の高いコンテンツの検証をサポートしています。ユーザーにとって有用なデータを収集し、収集したデータをさらに整理することができます。
管理ツール:抽出したデータの管理ツールを提供するため、ユーザーはデータのカテゴリ分けについて心配する必要がありません。また、予算管理ツールも提供し、ユーザーがソフトウェアの使用中に複雑な問題に直面しないようにします。
インポートとエクスポート:このソフトウェアは、データや構造化情報を他のプラットフォームにインポートおよびエクスポートできます。また、他のアプリケーションとの連携も可能で、ユーザーはデータを分析し、適切に活用できます。
自動化:Diffbotには自動化機能があり、抽出したデータをユーザーが意識することなく、自動的に抽出、分類、整理します。有用で最新のデータを自動的に分類し、ユーザーにとって作業をより簡単にします。
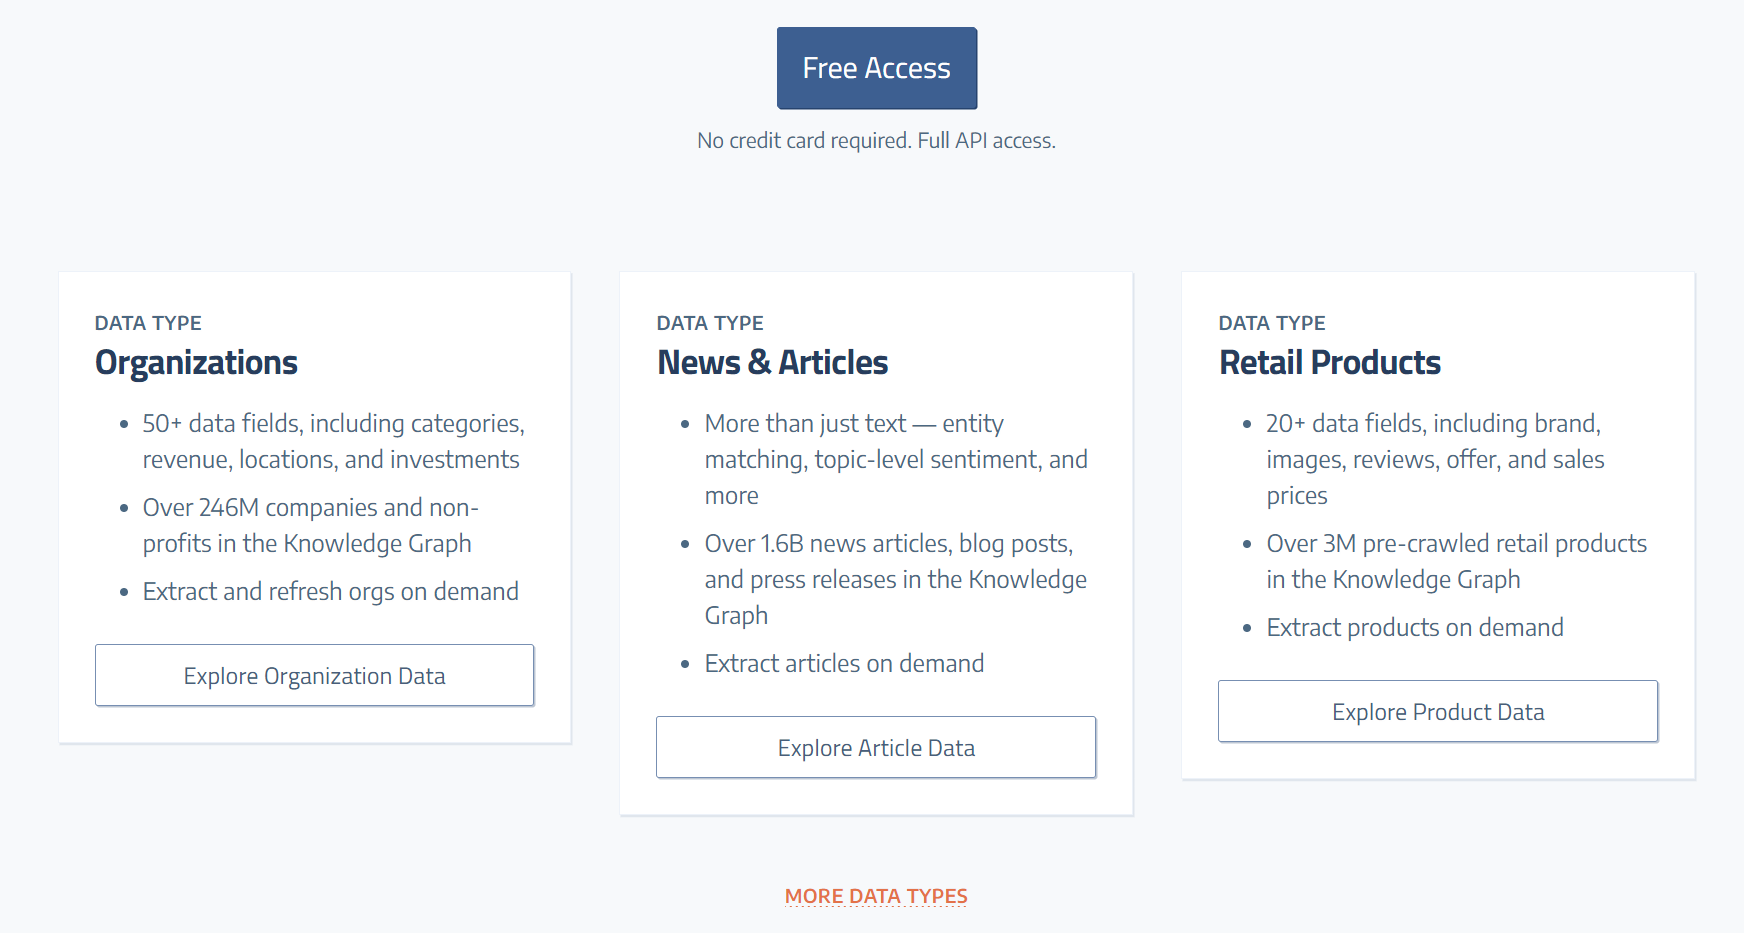
Diffbot の長所と短所
メリット
- ユーザーが独自の Web スクレイピング システムを構築する時間を節約するのに役立ちます。
- ウェブサイトから正確かつ詳細な情報を収集します。
- ソフトウェアの操作に必要な場合は、サポートが提供されます。
- 無料トライアルを利用して、その価値を確認してください。
デメリット
- Windows では使用できません。
- 初心者にとっては複雑な場合があります。
Diffbotの料金プラン
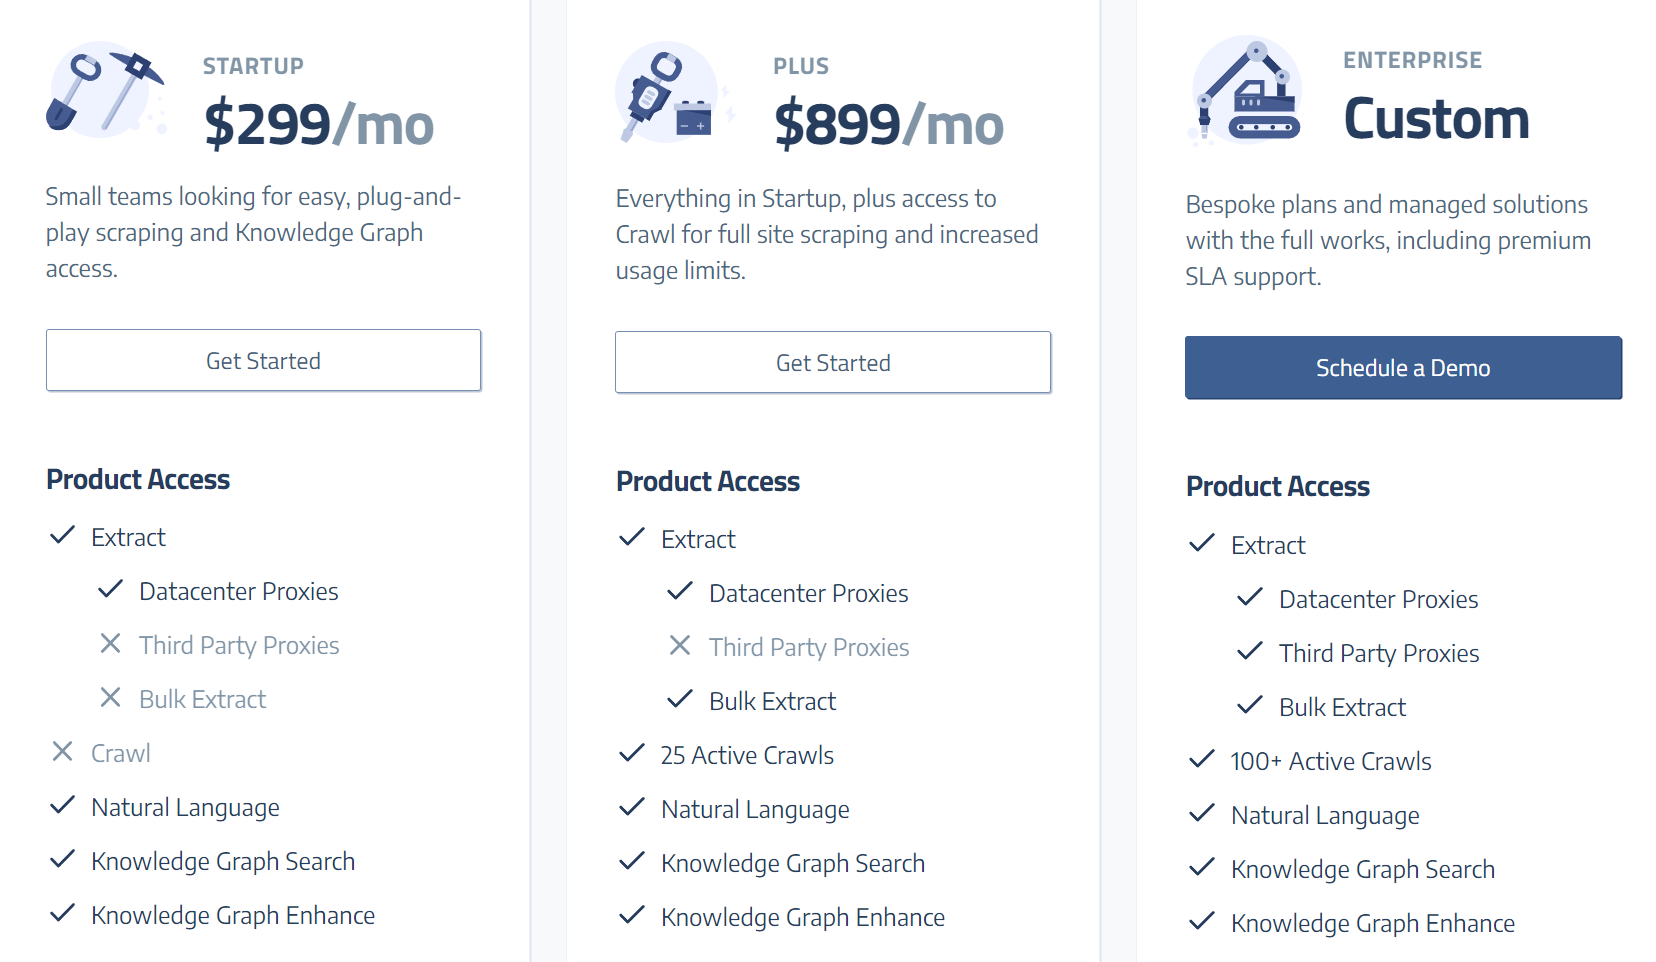
Diffbot スタートアップ プランは月額 299 ドルで、プラス プランは月額 899 ドルで利用できます。
オキシラブ
Oxylabs は、幅広い業界や電子プラットフォームにサービスを提供する、最も便利で信頼性の高い Web スクレイピング ソフトウェアの XNUMX つです。
通常、倫理的なデータ抽出を担当し、ユーザーのビジネスを支援します。
複数のプロキシの利用可能性:このソフトウェアは、市場調査、ブランドおよびメールの保護、レビューおよび価格の監視を実行するために、住宅用プロキシ、共有データプロキシ、専用データセンタープロキシなど、幅広いプロキシを提供します。
複数のプロキシを利用できるため、システムは自動的にプロキシをローテーションし、ユーザーのセキュリティを確保できます。
ブロック解除:Oxylabsのソフトウェアには、Webブロック解除機能が搭載されており、「不動産スクレイピング」に最適です。高度なアンチスクレイピングシステムを回避し、ユーザーに迷惑をかけることなく信頼性の高いデータを抽出します。また、地理的な制限を解除することで、IPアドレスでブロックされたWebサイトからデータを抽出することも可能です。
容易な統合:同社のプロキシサービスは、既存のアプリケーションやプロジェクトに簡単に統合でき、目的のシステムやウェブサイトからデータにアクセスできます。また、さまざまなウェブスクレイピングツールへのプロキシ統合機能も提供しており、データ抽出をより簡単かつ効率的に行うことができます。
広範囲かつグローバルなプロキシカバレッジ:世界中でアクセス可能な様々なプロキシを提供し、システムやウェブサイトのIPアドレスによるアクセス制限を回避することで、世界中の情報へのアクセスを可能にします。国、都市、大陸に関係なくデータにアクセスできます。
Oxylabsの長所と短所
メリット
- そのサービスは幅広い業界で利用可能です
- 自動濾過と回転をサポート
- ユーザーはセッションを管理して、信頼できるデータを収集できます。
- よりスムーズなデータ抽出のために利用可能なさまざまなプロキシ
- さまざまなIPロックを回避し、有用な情報にアクセスできます
デメリット
- 一部のユーザーにとって、プレミアム ツールにアクセスするには比較的高価な場合があります
- データへのアクセスの制御が低下する
- インストールに関する十分な知識が必要なため、一部のユーザーにとっては複雑になる可能性があります。
Oxylabsの料金プラン
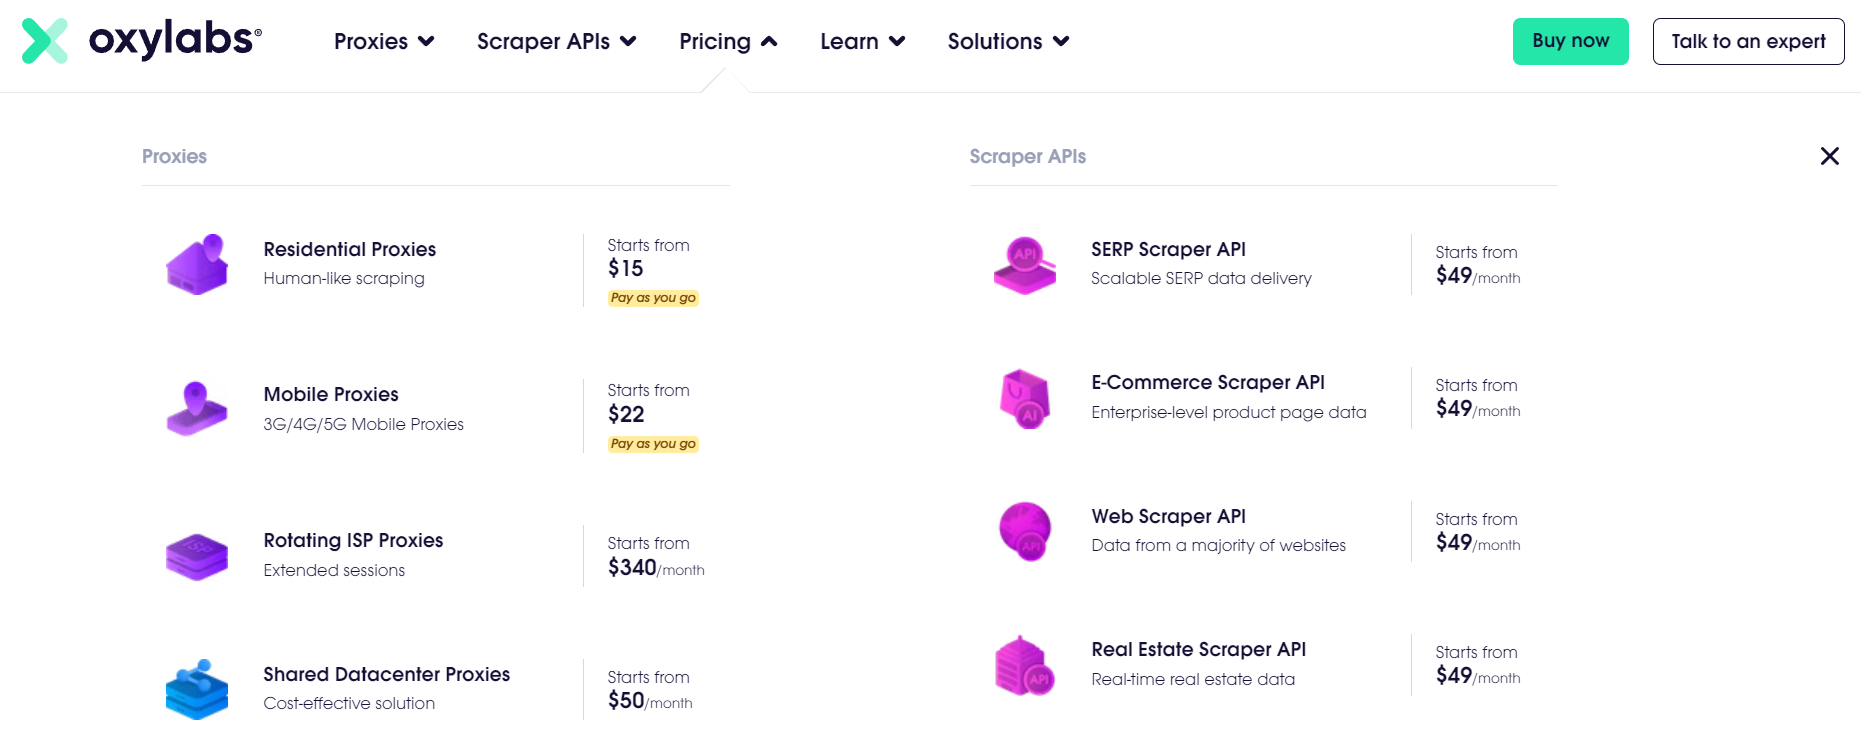
レギュラー
- 従量課金制 - 15 ドル/GB
- スターター–月額300ドル
- 上級–月額600ドル
- プレミアム– $ 800
Enterprise
- ベンチャー – 月額 1,750 ドル
- ビジネス– $ 3,000 /月
- 法人 – 月額 4,000 ドル
- Custom+ – 月額 5,000 ドルから
アピファイ
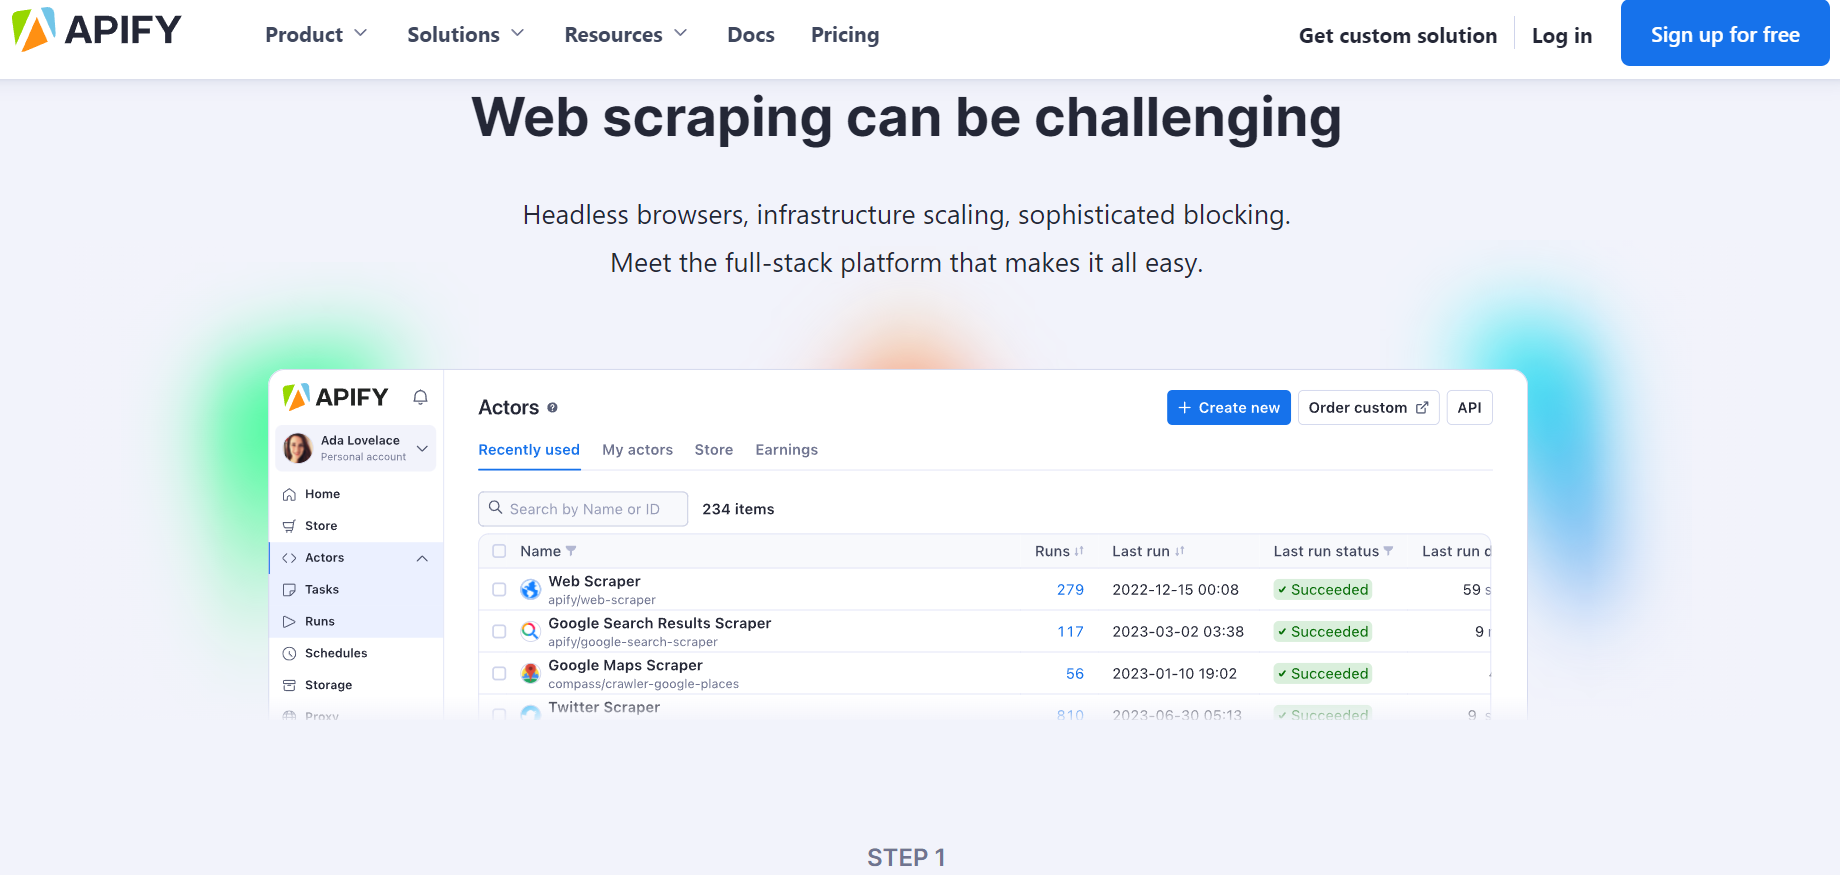
Apify は、ユーザーのビジネスにさらに役立つデータを Web サイトから抽出する Web スクレイピング ソフトウェアです。 Web クローラーを導入して Web サイトにアクセスし、情報を収集します。
データストレージソリューション:Apifyは、ユーザーがデータストレージを利用して、スクレイピングしたデータを保存し、適切に管理することを可能にします。使いやすく、ユーザーはデータを将来の使用のために便利な方法で保存できます。
プロキシローテーション:プラットフォーム上で利用可能なプロキシをローテーションする機能を提供し、IPブロックを解除して、ウェブサイトの制限されたデータにアクセスできるようにします。
Apifyアクター:これらは、簡単に統合できるWebスクレイピングツールです。カスタムコードなしで動作するため、タスクの実行が迅速になります。これらは事前に構築されており、一般的なWebスクレイピングに再利用できます。
カスタマイズ:Apifyでは、ユーザーは既存のアクターをニーズに合わせてカスタマイズできます。独自のタスクを実行するカスタムアクターを作成することも可能です。
自動化:重要な機能の一つに自動化機能があり、反復作業の自動化を実現します。この機能により、開発者の労力と時間を節約できるだけでなく、様々なウェブサイトを自動的に巡回して有用なデータを収集するのに役立ちます。
Apifyコミュニティ:ユーザーがヘルプやサポートを求めるためのプラットフォームを提供し、Apifyは関連するプロジェクトに関するユーザーの質問や問題に対する解決策を提供します。
Apify の長所と短所
メリット
- 難しいスクレイピングタスクに取り組むためのカスタマイズが可能になります
- ユーザーはIPブロッキングシステムをバイパスして信頼できるデータをスクラップできるようになります。
- ソフトウェアのユーザーフレンドリーなインターフェースにより、初心者でも簡単に使用できます
- 他のプラットフォームに簡単に統合して機能を向上させることができます
- 無料トライアルが利用可能です
デメリット
- サービスによっては料金が高くなる場合があります
- ソフトウェアの継続的な変更に伴うメンテナンスが必要です
- モバイルアプリのスクレイピングのためのツールや機能は含まれていません
Apifyの料金プラン
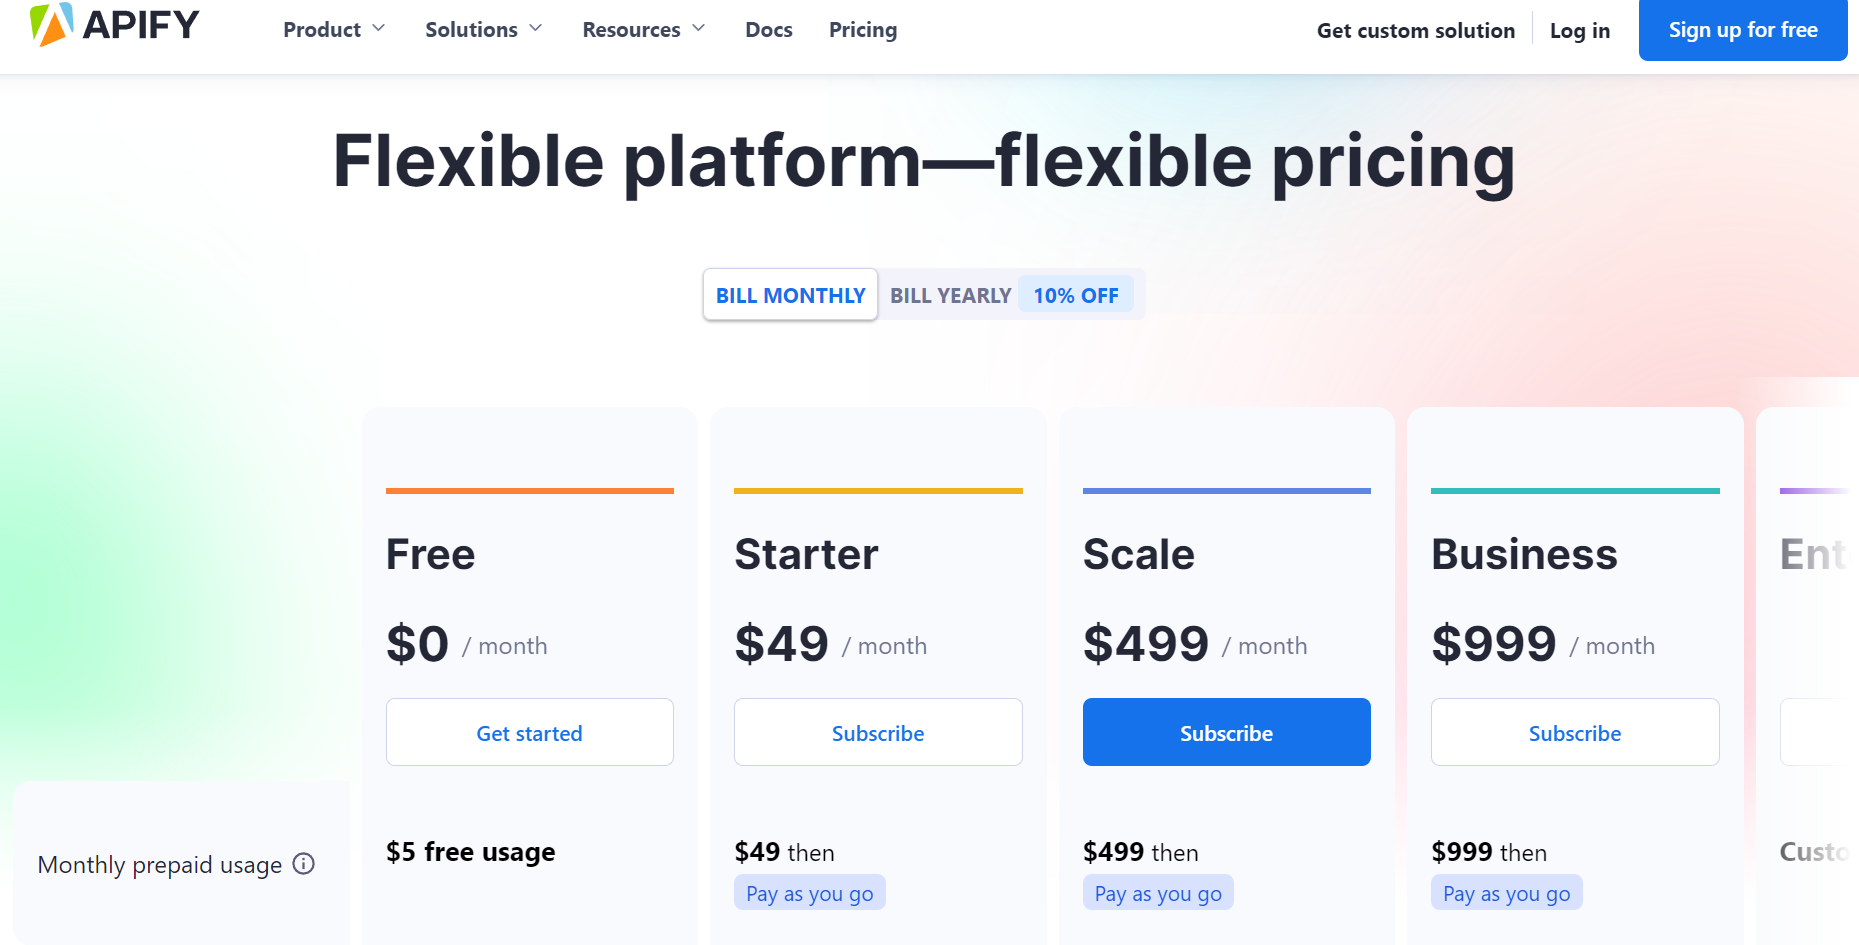
毎月の請求
- スターター–月額49ドル
- スケール – 月額 499 ドル
- ビジネス– $ 999 /月
- エンタープライズ – カスタム
年間請求
- スターター–月額44ドル
- スケール – 月額 449 ドル
- ビジネス– $ 899 /月
- エンタープライズ – カスタム
スクレイピングビー
Web サイトから情報を収集し、管理するための強力な Web スクレイピング ソフトウェアです。 また、ユーザーにとって役立つデータを抽出するための効率的なツールとソリューションも提供するため、高品質のデータ スクレイピング ソフトウェアになります。
JavaScriptレンダリング:これにより、ユーザーは、情報をスクレイピングして取得したい任意のWebサイトで、カスタムJavaScriptコードを実行できます。
ジオターゲティング:特定の地理的位置をターゲットにすることで、ユーザーがウェブサイトやウェブサイト上で利用可能なデータにアクセスできるように支援します。これはユーザーにとって役立つ可能性があります。
スクリーンショット:この機能を使うと、スクレイピングしたいウェブサイトの画面のスクリーンショットをキャプチャできます。HTMLコードを使わずに情報を収集できるため、ユーザーにとってより簡単になります。
自動管理:その機能の一つとして、ユーザーが適切なプロキシプロバイダーを探すのに何日も費やす必要がなくなります。データとブラウザを自動的に管理することで、ウェブスクレイピングをより簡単に行えるようになります。
カスタマイズ:コーディング不要でウェブスクレイピングエンジンをカスタマイズできます。コーディングの手間を省き、カスタマイズを可能にすることで、ユーザーの時間を節約します。
ScrapingBeeの長所と短所
メリット
- さまざまなWebサイトから一度にデータを抽出する一括スクレイピングが可能です
- SSL暗号化はユーザーのデータのプライバシーを維持します
- API スクレーパーの他のプラットフォームへの簡単な統合をサポート
- 信頼性が高く有用な継続的なデータ抽出を保証します。
デメリット
- 限定的なカスタマイズが可能です
- オフラインスクレイピングにはあまり信頼性がありません
ScrapingBeeの料金プラン
- フリーランス – 月額 49 ドル
- スタートアップ–月額99ドル
- ビジネス– $ 249 /月
- ビジネス+ – $599+/月
パースハブ
ParseHub は最も信頼性の高い Web スクレイピング ソフトウェアの XNUMX つであり、複雑なことをせずにあらゆる Web サイトからデータを抽出するためのさまざまな機能とツールを提供します。
以下に、ParseHub の機能、メリット、デメリット、料金プランを示します。
複数サイト間ナビゲーション:このプラットフォームは、複数のウェブサイトを同時にナビゲートできるため、個々のウェブサイトをスクレイピングする手間が省け、ユーザーの時間を節約できます。
アナリストとコンサルタント:業界、マーケティング、競争に関する有用なデータを分析するアナリストとコンサルタントを擁しています。高度なツールを活用してデータを分析し、ユーザーに正確な市場統計情報とビジネスに関するより深い洞察を提供します。
カスタムAPI:ウェブスクレイピング用のカスタムAPIを提供することで、ユーザーはスクレイピングソフトウェアをゼロから作成する手間を省くことができます。これにより、ユーザーは必要なデータをカスタマイズして、任意のウェブサイトからスクレイピングすることが可能になります。
可視化:ScrapingBeeはカテゴリを抽出し、データをTableauに統合した後、可視化します。
ParseHubの長所と短所
メリット
- あらゆるWebサイトをスクレイピングするためのさまざまな支援とソリューションを提供します
- スクレイピングされたデータをクリーニングするツールがあり、抽出されたデータの信頼性と正確性を保証します
- データのスケジュールされたスクレイピングを提供します
- スムーズな機能を保証するユーザーフレンドリーなインターフェイスを備えています。
デメリット
- ページスクレイピングの数が限られているため、より多くのスクレイピングを行うにはプランをアップグレードする必要があります
- 複雑なデータ抽出の場合、ユーザーには事前の技術知識が必要になる場合があります。
ParseHubの料金プラン
- 標準–月額189ドル
- プロフェッショナル–月額$ 599
- ParseHub – カスタム/月
スクレーパーAPI
これは、API 呼び出しを利用してさまざまな Web サイトからデータと HTML コードを受信するためのツール セットと機能を提供する強力な Web スクレイピング ソフトウェアです。
ヘッダーのカスタマイズ:ユーザーがHTTPヘッダーをカスタマイズできるため、ウェブサイトからのデータ抽出プロセスが柔軟になります。
ジオターゲティング:ScraperAPIのこの機能により、ユーザーは世界中のデータをスクレイピングできます。ユーザーは位置情報を設定し、その場所で利用可能なページや、その場所に存在するページから情報を取得できます。
CAPTCHA バイパス:その機能の 1 つは CAPTCHA バイパスです。これは、API 呼び出しを通じてユーザーが CAPTCHA をバイパスできるようにし、よりスムーズで中断のないデータスクレイピングを保証します。
ローテーションプロキシ:必要に応じて異なるプロキシサーバーに新しい接続を確立できるため、時間と労力を節約できます。
ScraperAPIの長所と短所
メリット
- プロキシ ローテーション機能を備えているため、そのボットと AI はユーザーが Web サイトで利用できる最新データを収集します。
- 必要に応じてユーザーに専門的なサポートを提供します。 さまざまなツールや機能についてのチュートリアルとソリューションが掲載されています。
- ユーザーフレンドリーなインターフェースにより、初心者でも簡単に使用できます。
- 予算に優しく、プランもお財布に優しいです。
デメリット
- 特定の地理的場所をスクレイピングの対象とする場合には制限があります。
- ユーザーがその月に利用可能なクレジットを使用しなかった場合、翌月に移行することはできません。
ScraperAPIの料金プラン
初心者向けに、5,000 日間有効な 7 の無料 API クレジットが提供されます。 無料のクレジットのほかに、ユーザーのニーズやビジネスの種類に基づいて 5 つの異なるサブスクリプション プランがあります。
その「Hobby」プランの料金は月額 49 ドルで、ユーザーに 100,000 API クレジットが提供されます。 ユーザーがスタートアップを利用している場合は、月額 149 ドルの「スタートアップ」プランを選択できます。
ユーザーは、月額 299 ドルで 3,000,000 API クレジットを提供する「ビジネス」プランを自分のビジネス向けに選択できます。
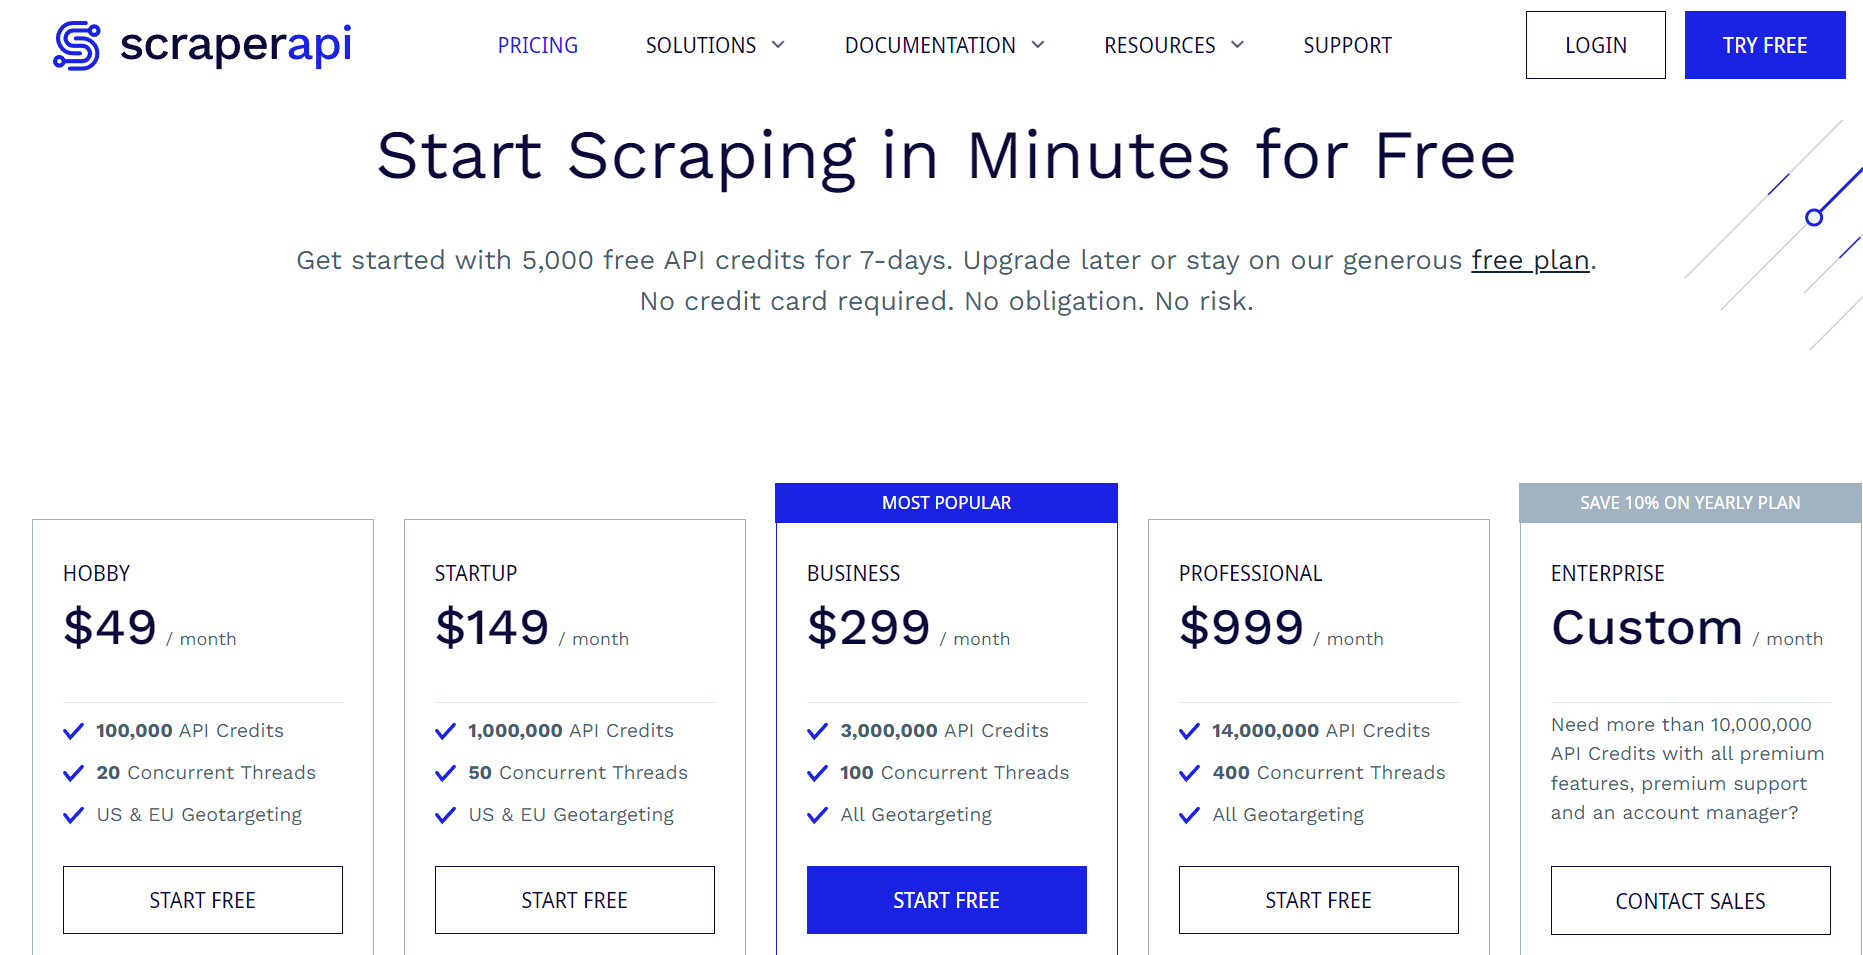
月額 999 ドルで 10,000,000 以上の API クレジットを提供する「プロフェッショナル」プランもあります。 これらのプランでもユーザーのニーズに適合しない場合は、予算と API クレジットのニーズに応じてカスタマイズできる「エンタープライズ」プランを選択できます。
Web スクレイピングには次の 5 つのステップが含まれます
1. ターゲット Web サイトのサーバーに HTTP リクエストを送信して、特定の Web ページの HTML コンテンツを取得することにより、Web サイトまたは Web ページの取得を開始します。
2. HTML データをフェッチした後の次のステップは、ライブラリを使用してそれを解析し、必要なデータを抽出することです。これらのライブラリを使用すると、HTML 構造をナビゲートして操作できます。
3. 次に、タグ、クラス、ID など、必要な HTML 要素を特定して選択する必要があります。
4. HTML 内に存在するテキスト、属性、リンク、画像、またはその他の情報などの関連データを抽出します。
5. データを抽出したら、ローカル ファイルまたはデータベースに保存したり、さらなる計算に使用したりできます。
よくあるご質問
Web スクレイピング ソフトウェアを使用すると、ソフトウェアが提供するツールや機能を利用して、特定の Web サイトからデータをスクレイピングまたは抽出できます。
ScrapingBee の代替として、Scraping API、ParseHub、Oxylabs、Brightdata などがあります。
はい、Scraping API では 7 日間無料トライアルを利用できます。
